La démo est facile. Un modèle lit un ticket, écrit une réponse, tout le monde applaudit. Six semaines plus tard, le même agent est discrètement débranché : il a inventé un numéro d'article, ouvert cinquante pull requests que personne n'a relues, et personne ne sait ce qu'il a coûté.
Les patrons ci-dessous partagent une propriété : l'agent produit un livrable qu'un humain sait déjà vérifier — un diff, un rapport de test, un brouillon, une liste de travail. Cette seule contrainte supprime l'essentiel du risque et toute la mythologie.
La base : un agent est une boucle avec des freins
Un agent qui fonctionne, c'est cinq choses :
- Un objectif formulé comme un résultat vérifiable (« tous les tests rouges passent, sans nouvelle erreur de lint »), pas une intention.
- Une surface d'outils étroite, typée, permissionnée. Un outil fait une chose et valide ses entrées.
- Un état gardé hors du modèle : un enregistrement de tâche, un journal, un fichier JSON. La fenêtre de contexte est un brouillon, jamais le système de référence.
- Un frein — un budget (tokens, appels d'outils, temps) et une porte (humaine, CI, politique) capables d'arrêter la boucle.
- Une trace — chaque prompt, appel, résultat et décision stockés, rejouables, attribuables.
Si vous ne pouvez pas pointer les cinq dans votre conception, vous avez un prompt, pas un agent. La distinction compte en audit.
La règle que j'applique : l'agent peut lire tout ce qu'on lui a accordé, proposer n'importe quoi, et ne rien modifier sans porte. Lire, proposer, écrire sous contrôle. Dans cet ordre.
Cas 1 — Des agents dans une migration SAP S/4HANA
Une migration est une activité géante, répétitive et vorace en preuves : dizaines de milliers d'objets custom, centaines de scripts de test, feuilles de réconciliation que personne ne veut porter. C'est un terrain de jeu idéal, parce que le travail est borné par des règles que SAP codifie déjà.
| Tâche | Ce que fait l'agent | Ce que l'humain garde |
|---|---|---|
| Tri du code custom | Lance l'ATC avec la variante S/4HANA, lit les constats, regroupe par cause racine, propose une catégorie (retirer / remplacer par le standard / adapter / réécrire en RAP) | La décision de retirer |
| Preuves d'usage | Croise résultats ATC, traces SQL et historique de transports pour montrer quels objets Z s'exécutent réellement | La validation de la décommission |
| Scripts de test | Lit le document de conception et produit des cas de test avec résultats attendus | L'acceptation métier de chaque cas |
| Réconciliation de données | Compare extraits legacy et cible sur les clés convenues, produit une liste de rejets motivée | L'approbation des tolérances |
| Runbook de cutover | Transforme le journal de la répétition en checklist séquencée, chronométrée, avec responsables et points de rollback | La maîtrise du cutover |
L'architecture qui tient
Gardez le modèle loin du système productif. Le patron est : extraction en lecture seule, raisonnement hors ligne, écriture sous contrôle.
SAP (DEV/QAS, RFC/OData en lecture)
   │  extraction : constats ATC, liste d'objets, données d'usage
   ▼
Zone d'atterrissage (Parquet / SQLite)  ←  l'agent travaille ici, pas dans SAP
   │
   ▼
Agent : classer → regrouper → proposer → rédiger la liste de travail
   │
   ▼
Livrable : CSV/Markdown + tickets Jira + page Confluence
   │
   ▼
Porte humaine : l'architecte relit, corrige, approuve
   │
   ▼
Transport de référence (uniquement après approbation)
Forcez une sortie structurée et une taxonomie fixe, et laissez le modèle s'abstenir :
REMEDY = Literal["retire", "standard_replacement", "adapt", "rewrite_rap", "unknown"]

class Finding(BaseModel):
    object_name: str
    object_type: Literal["PROG", "CLAS", "FUGR", "INCLUDE", "CDS"]
    atc_priority: int
    message_ids: list[str]
    remedy: REMEDY
    rationale: str = Field(max_length=400)
    confidence: float = Field(ge=0, le=1)
    needs_evidence: bool          # vrai -> route vers un humain, ne devine pas
Le piège : un agent qui « corrige » de l'ABAP est un passif. Un agent qui classe et cite de l'ABAP est un actif. Livrez le second : la remédiation reste aux développeurs, vous leur avez retiré 60 % de leur semaine passée à lire des constats.
Cas 2 — L'IA intégrée dans Microsoft Teams
Teams, c'est là où vos utilisateurs sont déjà : la surface la plus rentable et l'endroit le plus simple pour construire quelque chose que personne n'ouvrira deux fois. La différence n'est presque jamais le modèle — c'est de savoir si l'assistant répond dans la conversation où le travail se fait, avec les droits de la personne qui demande.
Trois formes, par valeur croissante
1. Questions/réponses sur votre corpus. RAG sur SharePoint, Confluence et politiques internes, filtré par groupes Entra ID. Utile, pas cher, et le premier que tout le monde construit. Plafond : il ne fait que répondre.
2. Bot d'action. L'assistant fait des choses via des outils typés : créer un ticket Jira, vérifier un bon de commande, demander un transport SAP. C'est là que l'adoption décolle, parce qu'on arrête de changer d'onglet.
3. Participant ambiant. Le bot vit dans un canal, observe, et propose le livrable avant qu'on le demande. Puissant, et le plus susceptible d'agacer. Par défaut, il se tait et on l'invoque.
La pile qui tient
- Identité : Entra ID avec flux on-behalf-of. Le bot ne doit jamais avoir de jeton super-utilisateur ; il agit en tant que l'utilisateur, donc les permissions fichiers sont appliquées par Graph, pas par votre prompt.
- Canal : Teams AI Library (ou Bot Framework pour l'ancienne surface), manifeste limité à une équipe pour le pilote.
- Connaissance : récupération sur sources sanctionnées uniquement. Découpage sur les titres, URL source et date de modification dans chaque chunk, citations systématiques.
- Actions : chaque outil enveloppe une API existante avec validation et entrée d'audit. Le modèle ne compose jamais de HTTP brut.
- Frontière de données : classez le corpus d'abord. Tout ce qui dépasse « interne » reste dans votre tenant — c'est une question achats, pas d'ingénierie, mais elle tue les projets tard.
Ce qui fait revenir les utilisateurs
- Répondre dans le fil, pas dans un onglet. S'il faut quitter la conversation pour obtenir la valeur, on arrête.
- Montrer les sources, en ligne. Une ligne avec le document et la date : c'est la différence entre confiance et gadget.
- Dire « je ne sais pas » vite. Une réponse fausse et confiante sur un bon de commande coûte plus cher que cent « introuvable ».
Cas 3 — Des agents qui travaillent ensemble : Jira, Confluence, tests, releases
Le cas intéressant, et celui que la plupart des équipes ratent en commençant par cinq agents au lieu d'un. La forme qui fonctionne est un superviseur avec des spécialistes, pas une démocratie de pairs : un orchestrateur possède le plan et l'état, les spécialistes ont des compétences étroites, et l'orchestrateur décide de la suite.
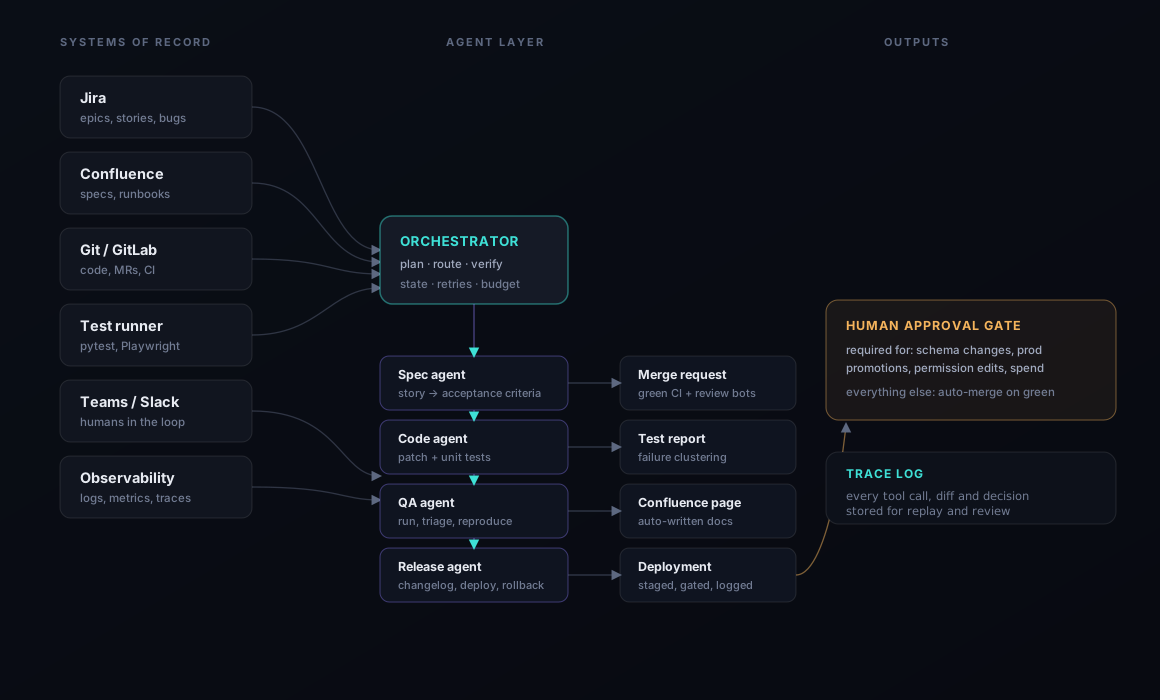
Le flux, du ticket à la production
- Triage. L'orchestrateur récupère un ticket Jira par webhook, lit la description et la page Confluence liée, écrit un plan : quels spécialistes, dans quel ordre, et ce que « terminé » veut dire.
- Spécification. L'agent spec transforme l'histoire en critères d'acceptation et en liste explicite de fichiers à toucher. C'est le contrat auquel tout le reste sera mesuré.
- Construction. L'agent code travaille sur une branche, produit un diff et des tests, et exécute la suite avant de passer la main. Pas de diff, pas de passage.
- Vérification. L'agent QA lance le pipeline et, en cas d'échec, reproduit le bug isolément, regroupe les échecs et rédige un diagnostic. Il ne « corrige » rien : séparation des pouvoirs, à bas coût.
- Documentation. L'agent docs écrit la mise à jour Confluence et la note de version à partir du diff et du plan, pas de son imagination.
- Release. L'agent release rédige le changelog, ouvre la MR, tague, déploie en staging. La promotion en production attend la porte humaine.
Les contrats d'outils : la partie que tout le monde saute
Écrivez la couche d'outils avant le moindre prompt. Chaque outil : arguments typés, réponse validée, une ligne d'audit, et une clé d'idempotence pour qu'un appel rejoué n'ouvre pas deux fois le même ticket.
| Outil | Signature | Garde-fou |
|---|---|---|
jira.get_issue | (key) → Issue | lecture seule, projets autorisés |
jira.create_issue | (projet, résumé, corps, labels) → clé | dédoublonnage par hash, max 3/exécution |
confluence.read | (page_id) → markdown | espaces autorisés |
confluence.write | (page_id, markdown) → version | brouillon seulement ; l'humain publie |
repo.apply_patch | (branche, diff) → commit | préfixe agent/, jamais main |
ci.run | (ref, suite) → rapport | timeout 20 min, plafond de coût |
deploy.staging | (image_ref) → url | staging uniquement, rollback auto |
deploy.prod | — | non exposé à l'agent |
Cette dernière ligne, c'est tout le design. L'agent n'a pas d'outil de déploiement en production : « l'agent a déployé en prod » n'est pas un mode de défaillance, c'est une impossibilité. La capacité est une frontière de sécurité, pas une consigne dans un prompt.
Commencez par un seul spécialiste. Livrez l'agent QA seul pendant un mois : il lance le pipeline, reproduit les échecs, les regroupe et écrit le diagnostic dans Jira. Il est presque en lecture seule, immédiatement utile, et il vous apprend les contrats d'outils nécessaires au reste. La plupart des équipes qui échouent ont voulu commencer par les cinq.
Évaluation, ou vous volez à l'aveugle
Gardez un petit ensemble de vrais tickets avec des résultats connus — 30 suffisent pour commencer. Chaque changement de prompt ou de modèle rejoue l'ensemble. Trois mesures :
- Succès de la tâche — le livrable passe-t-il la même revue qu'un livrable humain ? (MR mergée, ticket accepté, suite verte)
- Régression — a-t-on cassé ce qui passait ? Distinguez instabilité et vrai défaut.
- Coût et étapes — tokens et appels par ticket accepté. 10 % de qualité pour 3× le coût est presque toujours un mauvais échange.
Le modèle d'exploitation dont personne ne parle
Quatre questions décident si tout cela tourne encore dans un an :
- Qui en est propriétaire ? Une personne nommée, dans une vraie équipe, avec l'astreinte. « Le CoE IA » n'est pas un propriétaire.
- Combien ça coûte par mois, et qui approuve ce chiffre ? La dépense de modèle est un coût d'exploitation avec une ligne budgétaire.
- Comment l'éteindre ? Un feature flag par agent, désactivé par défaut, documenté dans le runbook.
- Qu'a-t-il interdiction de faire ? Écrit, appliqué dans le code, testé comme n'importe quel contrôle.
Checklist de mise en production
Avant le pilote : une tâche mesurable, une porte humaine, une surface d'outils, un stockage de traces.
Avant de passer à l'échelle : un jeu d'évaluation de ≥ 30 cas, un chemin d'abstention, un plafond de coût, un propriétaire nommé, un interrupteur.
Avant de toucher au productif : accès en lecture seule, identifiants séparés, et une liste écrite de ce que l'agent ne peut pas faire — appliquée dans le code, pas dans un prompt système.
La suite côté matériel : la construction du drone de reconnaissance ; côté programme : les décisions d'une migration S/4HANA. Pour faire relire une architecture agentique sur un programme précis, la page contact est le chemin le plus court.