La plupart des plans de migration sont un Gantt avec une promesse attachée. La version utile est une liste de livrables : une chose qui existe à la fin de chaque semaine, que quelqu'un a signée, dont la phase suivante dépend. Activate donne la liste. Cloud ALM est l'endroit où elle vit. Ni l'un ni l'autre ne prendra une décision à votre place.
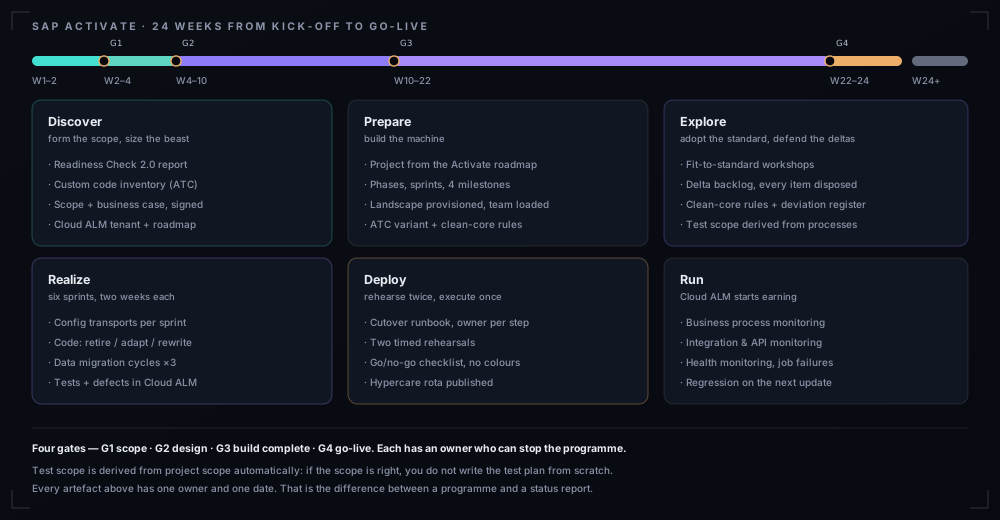
Ce qui suit est un plan de conversion de 24 semaines pour un paysage ECC de taille moyenne — assez long pour être réel, assez court pour être ambitieux. Ajustez les durées, gardez la séquence et les portes.
Semaine 1, jour 1 : installer le système de référence
Avant le moindre atelier, avant de réserver le moindre consultant, le programme a besoin d'un endroit unique où le statut est vrai. Six choses se configurent la première semaine, et cela représente environ deux jours de vrai travail :
Provisionner SAP Cloud ALM
Demander le tenant, activer le service, connecter les paysages. Cloud ALM est inclus avec votre contrat de support — ce n'est pas une décision d'achat, c'est une tâche de mise en place que les gens repoussent pendant des mois, puis pilotent le programme dans Excel.
Créer le projet depuis la roadmap Activate
Choisissez la roadmap de conversion S/4HANA pour votre édition. Cloud ALM génère la liste des tâches automatiquement, avec descriptions et accélérateurs. Cette liste est votre méthodologie — pas un PDF.
Définir les timeboxes : 6 phases, 6 sprints, 4 jalons
Les phases et les sprints existent comme objets dans Cloud ALM, pas comme onglets dans un tableur. Durée de sprint : deux semaines. Tout autre choix ouvre un débat dont vous n'avez pas besoin.
Charger l'équipe avec les rôles
Chaque tâche reçoit une affectation de rôle. Un rôle sans nom en semaine 1 est un trou en semaine 12.
Brancher les portes qualité
Quatre portes : périmètre (S2), conception (S4), build terminé (S22), go-live (S24). Chacune a une checklist de sortie et un propriétaire ayant le droit de dire non.
Décider la ligne de reporting
Un extrait hebdomadaire de Cloud ALM : tâches en retard, exigences par statut, taux de réussite des tests, défauts ouverts par sévérité. Si le comité voit un autre chiffre que l'équipe, vous avez deux programmes.
La règle pour toute cette page : chaque activité produit un livrable qui vit dans Cloud ALM et qui a un propriétaire. « On a fait l'atelier fit-to-standard » n'est pas un livrable. « 47 exigences dans le backlog delta, 12 rejetées comme standard, 35 approuvées par le propriétaire de processus le 14 mars » en est un.
Semaines 1–2 · Discover : que convertit-on, exactement
Discover est court et c'est là que le business case est confronté au réel. Trois outils font l'essentiel du travail.
| Livrable | Produit avec | Pourquoi ça compte ensuite |
|---|---|---|
| Rapport Readiness Check | SAP Readiness Check 2.0 | Simplification items, empreinte du code custom, dimensionnement. La seule estimation honnête avant Explore. |
| Inventaire du code custom | Custom Code Migration + ATC | Nombre d'objets, preuves d'usage, catégories de remédiation. Le mode de défaillance n°2 commence ici. |
| Déclaration de périmètre | Périmètre + hiérarchie de processus dans Cloud ALM | Elle pilote le périmètre de test automatique. Faites la liste des processus correctement une fois. |
| Schéma du paysage | Document d'architecture | Nombre de mandants, DEV/QAS/PRD, interfaces, tiers. |
| Business case chiffré | Finance + programme | Coût mensuel du retard. Vous en aurez besoin quand une porte sera contestée. |
Porte 1 — fin de semaine 2. Périmètre signé par le propriétaire métier, rapport de readiness revu, inventaire du code suffisamment complet pour chiffrer. Si l'inventaire n'est pas complet, vous n'avez pas un périmètre, vous avez une intention.
Semaines 2–4 · Prepare : construire la machine
- Paysage. DEV, QAS, PRD provisionnés ; un bac à sable pour l'ATC et l'analyse de code ; la conversion elle-même exige une copie séparée pour les répétitions SUM.
- Variante ATC validée. Décision technique que l'on repousse pendant des semaines : quels contrôles S/4HANA tournent, à quelle priorité, et qui trie les constats. À trancher en Prepare, sinon chaque développeur invente sa réponse.
- Onboarding de l'équipe. Pas un slide deck — une session où chacun ouvre Cloud ALM et trouve ses tâches du sprint 1.
- Politique clean core écrite. Cinq règles, un registre, et une porte de transport qui peut refuser.
- Inventaire des interfaces. Chaque interface, son propriétaire, son sens, son protocole, et sa survie à S/4HANA. Les interfaces sont l'endroit où les conversions dérapent discrètement.
Porte 2 — fin de semaine 4. Paysage en service, variante ATC validée, règles clean core signées, inventaire d'interfaces complet, backlog du sprint 1 peuplé d'user stories dans Cloud ALM.
Semaines 4–10 · Explore : fit-to-standard et deltas défendables
Explore est le moment où le programme adopte le standard ou reconstruit son passé. La mécanique vient d'Activate : des ateliers fit-to-standard contre le contenu de processus préconfiguré, chaque écart capturé comme exigence delta, et une décision pour chacune.
Des ateliers par domaine de processus, pas par module
Order-to-cash, procure-to-pay, record-to-report… Chaque atelier a un propriétaire métier capable de dire « on change », et un journal de décisions écrit pendant la session, pas après.
Chaque écart devient une exigence avec une disposition
Dans Cloud ALM : standard, configure, extend, side-by-side ou reject. Une exigence sans disposition n'est pas une exigence, c'est un souhait.
Le clean core est une politique, appliquée par exigence
Aucune modification d'objet standard. Extensions via points d'extension released. API released uniquement. Side-by-side pour tout ce qui est lourd. Chaque écart au registre, avec propriétaire et date d'expiration.
Modèle de données et volumétrie
Quelles tables portent le volume, quoi archiver, quoi garder. Décidez l'archivage maintenant — cela change le dimensionnement, la durée de la migration, et parfois le business case.
Le piège d'Explore : un atelier qui finit par « on verra dans le sprint » produit un delta que personne n'a chiffré. Toute exigence qui sort d'un atelier sans disposition, sans estimation et sans propriétaire est une surprise planifiée pour Realize.
Les règles clean core, sous une forme opposable
| Règle | Appliquée comment | Si on demande une exception |
|---|---|---|
| Aucune modification d'objet standard | Porte de transport + revue de code | On reconçoit l'exigence. Il n'y a pas de chemin d'exception. |
| Extensions via points d'extension released | Nommées, versionnées, avec propriétaire | RAP ou side-by-side, tranché en Explore |
| API released uniquement | Registre d'interfaces | Propriétaire, version, date de dépréciation — sinon ça ne part pas |
| La logique lourde reste hors du noyau | Revue d'architecture | Service BTP / side-by-side avec son propre cycle de vie |
| Chaque écart est enregistré | Registre avec expiration | Les écarts datés se corrigent ; les autres deviennent la prochaine migration |
Code custom : le tri qui survit
C'est là que 60 % de l'effort se cache dans 2 % des objets. Dans cet ordre, semaines 5 à 10 :
- Inventaire. Chaque objet custom avec type, taille, dernière modification, auteur, système de transport.
- Preuve d'usage. ABAP Call Monitor / trace SQL / historique de transports sur 12 mois. Un objet que personne n'a exécuté depuis un an est un candidat au retrait, pas un objet de migration.
- ATC avec la variante S/4HANA. Uniquement les blocages techniques — cela ne dit pas ce que fait le code, d'où l'étape 2 d'abord.
- Quatre catégories : retirer, remplacer par le standard, adapter, réécrire (RAP ou side-by-side).
- Chiffrez en jours-développeur, pas en nombre d'objets. « 1 200 objets » ne dit rien ; « 180 objets, 340 jours, 14 semaines à quatre développeurs » dit quelque chose.
Le ratio attendu : 30–50 % de candidats au retrait, 20–30 % couverts par le standard, 20–30 % réellement réécrits. Les programmes qui sautent l'analyse d'usage supposent 100 % à migrer — et dimensionnent en conséquence. C'est aussi le seul endroit où un agent aide vraiment : classification et collecte de preuves à l'échelle, avec un humain qui approuve chaque remédiation. Voir les playbooks agents.
Semaines 10–22 · Realize : six sprints, et ce qui tourne en parallèle
| Sprint | Configuration | Code | Données & tests |
|---|---|---|---|
| S1 · S10–12 | Finance cœur + données de base | Liste de retrait exécutée (objets supprimés, pas migrés) | Golden records définis |
| S2 · S12–14 | Cœur logistique | Adaptations, premières extensions RAP | Cycle de migration 1 (DEV) |
| S3 · S14–16 | Reste du périmètre + intégrations | Interfaces reconstruites sur API released | Tests unitaires + intégration branchés |
| S4 · S16–18 | Rôles, autorisations, sorties | Corrections de performance issues de l'ATC | Cycle 2, règles de réconciliation signées |
| S5 · S18–20 | Outillage de cutover, archivage | Corrections de régression | Pack de régression complet au vert |
| S6 · S20–22 | Gel + résorption des défauts | Défauts uniquement, aucun périmètre | Cycle 3 à volumétrie de production |
Les tests, façon Cloud ALM
La propriété importante du test management de Cloud ALM est la traçabilité : le périmètre de test est dérivé du périmètre projet, les cas de test viennent du contenu de processus métier, et ils s'affectent aux exigences et aux user stories. Une exigence sans test devient donc un trou visible, au lieu d'être découverte en recette.
Un plan de test par sprint, plus un plan bout-en-bout pour le déploiement
Les deux vivent dans Cloud ALM. Le plan de sprint prouve l'incrément ; le plan bout-en-bout prouve le métier.
Manuel là où il faut juger, automatisé ailleurs
Golden records, smoke tests d'interface et packs de régression s'automatisent via votre fournisseur d'automatisation, orchestrés depuis Cloud ALM.
Défauts triés chaque jour, avec une définition du P1 arrêtée avant le go-live
Si tout est P1, rien n'est P1. Écrivez la définition en Prepare, pas pendant l'hypercare.
La disponibilité métier est la contrainte que personne ne planifie. Les mêmes quinze utilisateurs clés doivent tester, former, valider et faire tourner le business. Bloquez leur temps en Prepare, dans leurs agendas, avec l'accord de leur manager — sinon le sprint 5 glisse parce que personne ne pouvait venir en recette.
Semaines 22–24 · Deploy : répéter, puis faire une fois
Runbook de cutover : chaque étape a un responsable, une durée et une vérification
« Charger les données de base — 45 min — contrôler les volumes et un échantillon de 20 » plutôt que « charger les données ».
Deux répétitions chronométrées
Une à volumétrie de production, une avec les vraies personnes qui seront réveillées à 2 h du matin. La seconde est la plus utile.
Un point de rollback après chaque étape majeure, avec une heure de décision
La question « on rollback ? » se pose à 4 h par une personne nommée, elle ne se découvre pas à 9 h.
Go/no-go avec une checklist explicite
Défauts P1 ouverts = 0, réconciliation signée, readiness métier confirmée, hypercare staffé. Chaque ligne est un oui ou un non, pas une couleur.
Rota d'hypercare publiée avant le go-live
Personnes nommées, créneaux, chemin d'escalade, règle de triage. Quiconque a vécu un go-live sait que les 72 premières heures décident de la perception du projet entier.
Semaine 24+ · Run : à quoi sert Cloud ALM après le go-live
Cloud ALM ne s'arrête pas au go-live ; c'est là que ses applications d'exploitation commencent à rapporter. Quatre choses à activer la semaine d'hypercare :
- Business Process Monitoring — les processus vont-ils au bout, de bout en bout, avec le volume attendu ? Cela attrape l'intégration qui s'arrête silencieusement à 3 h du matin.
- Integration & API Monitoring — chaque interface, son taux d'erreur, sa latence. L'écran le plus précieux du premier mois.
- Health Monitoring — disponibilité, jobs en échec, exceptions.
- Tests de régression pour la mise à jour suivante — les mêmes cas, rejoués sur la nouvelle version. C'est ce qui transforme les upgrades en routine.
Douze erreurs, et ce que chacune coûte
| # | Erreur | Ce qu'on voit | Ce que ça coûte |
|---|---|---|---|
| 1 | Pas de définition écrite de « terminé » | Tout est vert, puis plus rien | Des semaines, découvertes tard |
| 2 | Code custom inventorié seulement « dans le périmètre » | Des objets apparaissent au sprint 4 | Replanification, 4–8 semaines |
| 3 | Clean core slogan | Chaque exception validée par épuisement | La même dette, version 2 |
| 4 | Exigences delta sans disposition | « On verra dans le sprint » | Périmètre non planifié, non budgété |
| 5 | Qualité des données repoussée au script de mapping | Un développeur qui décide du métier à minuit | Des données fausses en production, pour toujours |
| 6 | Aucune clé de réconciliation écrite | « La finance vérifiera » | Go-live bloqué à la dernière porte |
| 7 | Périmètre de test construit à la main au lieu du modèle de processus | Des centaines de tests, zéro traçabilité | Régression complète en semaines |
| 8 | Disponibilité métier supposée infinie | Ateliers à 3 participants sur 15 | Glissement que personne ne porte |
| 9 | Une seule répétition, annulée | Le plan n'avait pas de marge | La première répétition est la dernière chance |
| 10 | Archivage décidé après le dimensionnement | Fenêtre de migration trop courte | Matériel en plus ou indisponibilité plus longue |
| 11 | Interfaces sans propriétaire | Le système tiers « casse sans raison » | Pompier pendant l'hypercare |
| 12 | Deux sources de vérité (Excel + Cloud ALM) | Deux rapports de statut, deux vérités | La confiance, puis le budget |
Ce qu'il faut reporter chaque semaine
Une page, issue de Cloud ALM, pas de la mémoire de quelqu'un :